
前言
目前,大多数 AI 图像编辑工具都依赖纯文本 Prompt来描述需要修改的内容以及具体的修改方式。
然而,当图像编辑任务变得更加复杂时,编写 Prompt 很快就会变得繁琐。更重要的是,有时候仅靠文本很难准确指出图像中需要编辑的具体位置。
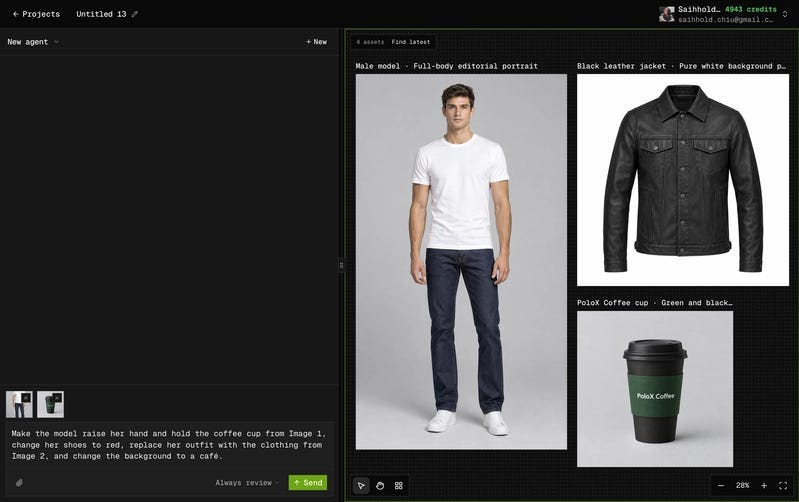
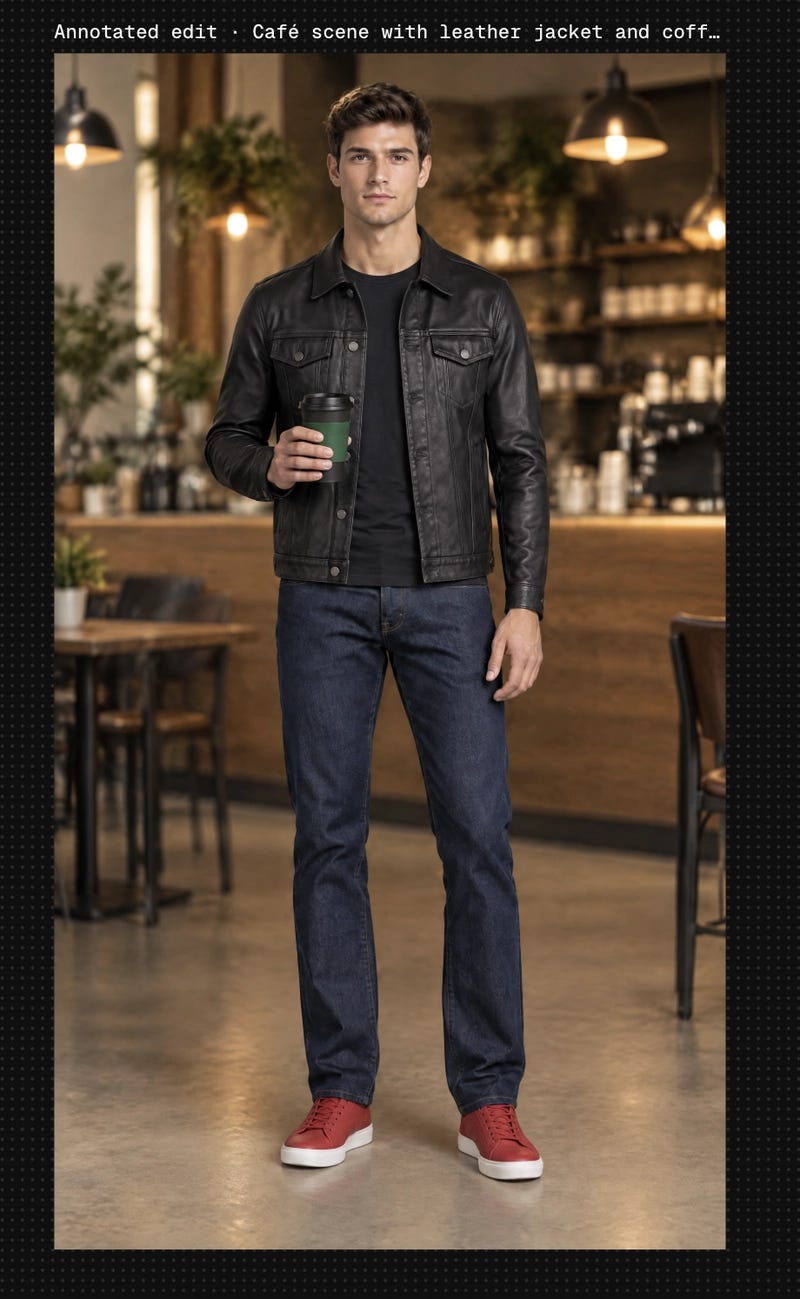
例如,假设我想对下面这张图片进行多项修改:
- 让模特拿着一个指定的物品
- 将她的鞋子颜色改为红色
- 将她的服装替换为指定的衣服
- 将背景环境修改为咖啡厅
使用传统的纯文本方式,我可能需要编写这样的 Prompt:
让模特举起手并拿着 Image 1 中的咖啡杯,将她的鞋子改为红色,将她的服装替换为 Image 2 中的服装,并将背景修改为咖啡厅。
标注 & 评论编辑
我通过一种新的交互方式简化了这一流程。
用户不再需要编写很长的 Prompt ,只需要直接在图片上放置标记点,并在对应的输入框中简要描述希望进行的修改。
这样,就可以通过视觉标注准确告诉模型在哪里进行修改,同时使用简短的文本指令说明要修改什么。
实现方法与实际测试
1. 选择图像编辑模型
目前,这种方法已经在以下图像编辑模型中取得了不错的效果:
- GPT Images 2.5 Flare / Sunburst
- Nano Banana 2
- Seedream 5.0 Pro
根据这些测试结果,我认为这种方法同样值得在后续发布的新一代图像编辑模型上进行测试。
下面的示例展示了在 PoloX AI PoloX AI 中使用 GPT Images 2.5 Sunburst 进行的一次实际测试。
该实现已经开源,可以在 GitHub 上查看:
https://github.com/saihhold-zhao/polox_ai
2. 使用 Image Annotation Edit Skill
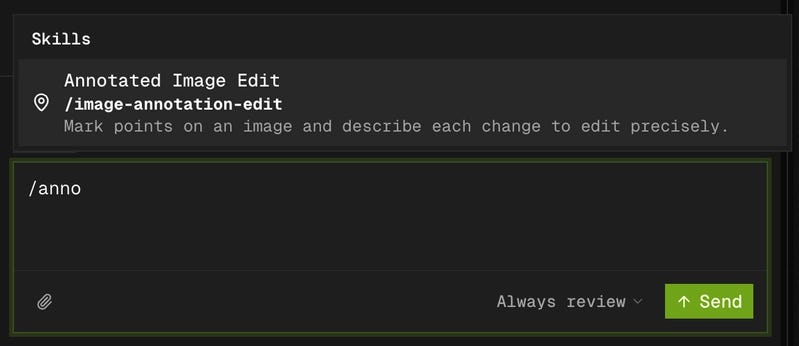
1. 触发 Skill
使用:
/annotated-image-edit
触发 Image Annotation Edit Skill。
2. 进入标注编辑模式
选择 Annotation Editing Mode,打开图像标注工具。
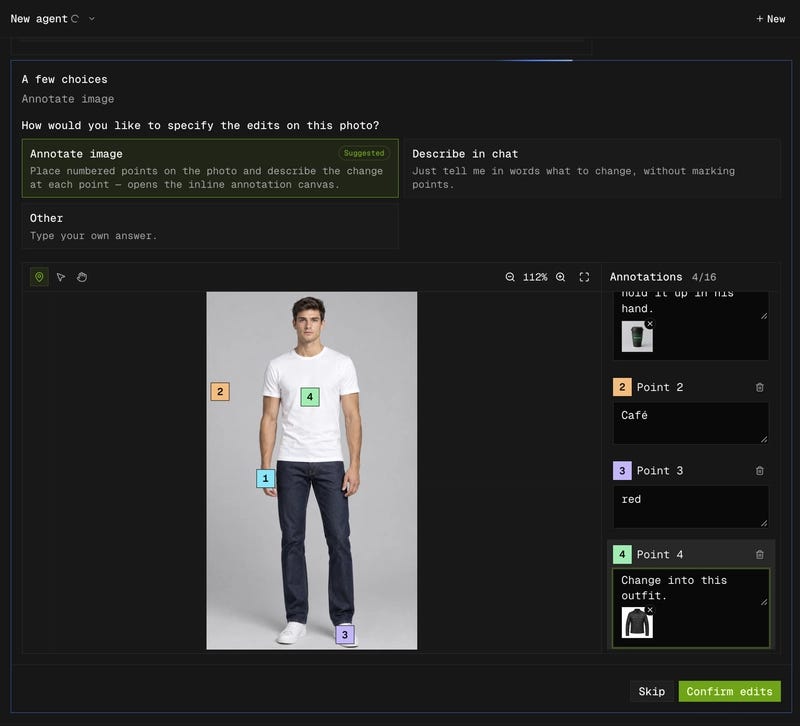
3. 添加标记点和编辑指令
直接在图片中需要修改的位置放置一个标记点,然后在对应的输入框中输入简短的修改指令。
例如,如果你想把鞋子修改为红色:
在鞋子上放置标记点 → 输入“red”
就这么简单。
如果需要使用参考图片,也可以直接在对应的输入框中上传。
例如,如果你想让模特拿着一个指定的咖啡杯:
在她的手上放置标记点 → 输入“raise her hand and hold this” → 上传咖啡杯参考图片
这样就建立了目标位置、编辑指令和参考图片之间清晰的对应关系。
4. 让 Agent 分析标注
完成所有标注后,点击 Continue 。
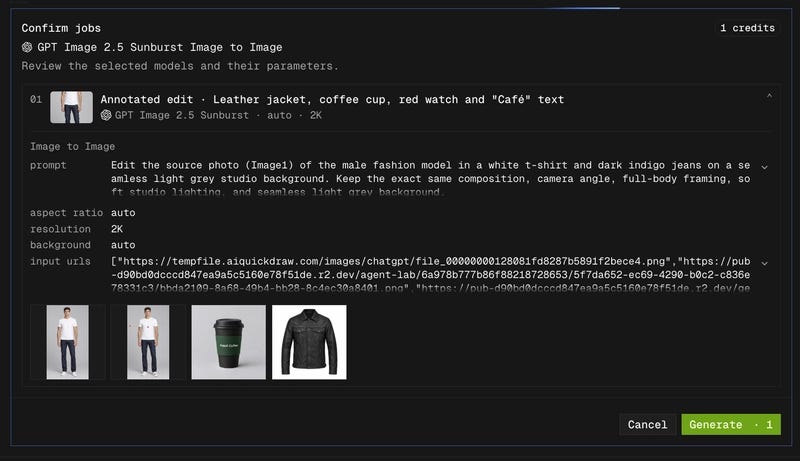
视觉语言模型会分析所有标注信息,Agent 则会自动准备图像编辑模型所需的参数和 Prompt 。
这里有一个非常重要的实现细节:
Agent 会向图像编辑模型发送两张图片:一张原始图片,以及一张包含视觉标注的图片。
因此,不需要担心标记点会遮挡原始图片中的部分内容。
模型可以通过带标注的图片理解编辑应该发生在哪里,同时仍然可以访问干净的原始图片,从而获得完整、无遮挡的视觉信息。
5. 获取结果
完成以上步骤后,图像编辑模型会根据 Agent 准备好的编辑指令生成最终结果。
总结
这种 Annotation + Comment (标注 + 评论) 的方式可以显著简化 AI 图像编辑流程。
用户不再需要编写复杂的 Prompt ,而是可以直接指出想在哪里进行修改,并简单描述想修改什么。之后,Agent 会自动完成 Prompt 构建和参数配置。
你可以在本地部署 PoloX AI ,并通过以下项目测试这一实现:
 Select Language