
前言:strata 最近已经火出圈了,火到 RAM 又翻了个倍。目前京东自营,海力士颗粒的 64GB 的 DDR5 6000 内存已经几近破万。
十一长假回来,笔者也是暂时小试牛刀了一把,发现有一些关键参数,会直接影响整个 LLM 引擎的本质体验,但是默认值并不是特别合理。所以发个 tips 小文供大家交流。欢迎批评指正。
本文全程手打,无任何 AI 含量,请放心阅读。
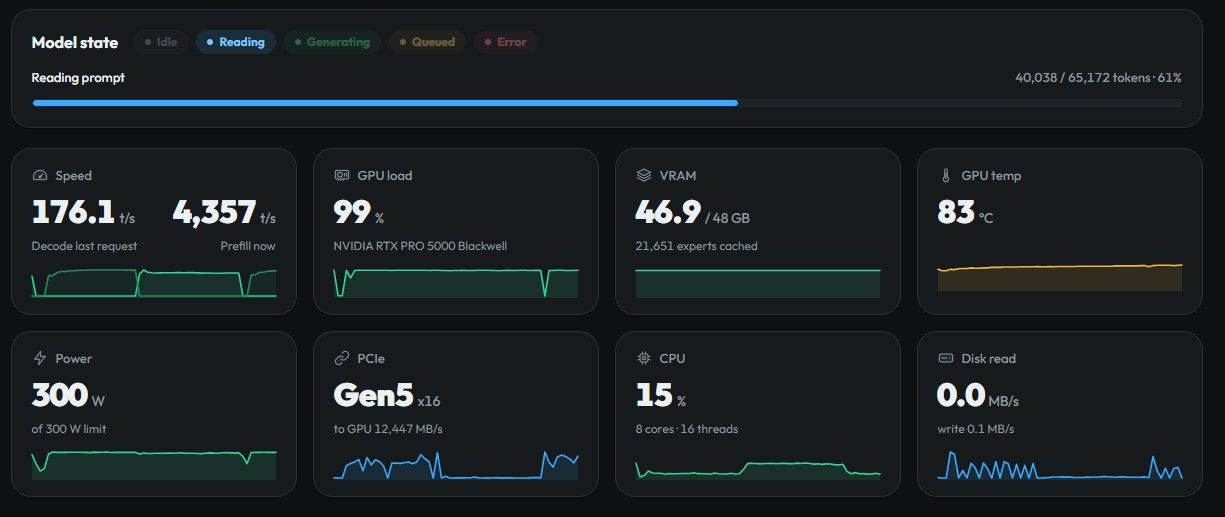
1 、Harness 会频繁唤起子代理( sub agent ),导致切换会话 prefill 浪费太多时间,怎么办?
答:开启--conversation-cache-mib
这个参数会让 strata 使用 RAM 来缓存历史对话,从而不让 LLM 反复重新 prefill 老的 session 。增加会话切换时的速度,对于 agent 、harness 场景有奇效。
开启 conversation-cache-mib 后,monitor 面板会有如下展示:
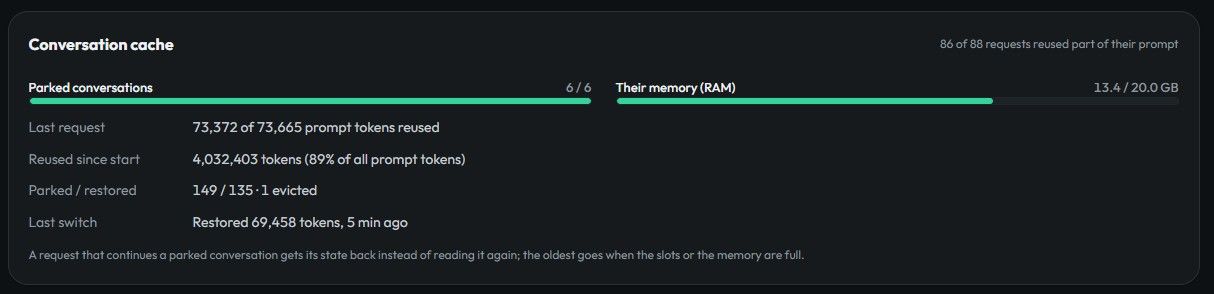
分别表述当期缓存了多少个会话,以及目前占用了多少 RAM 。
这个机制有个痛点:不支持多显卡。
2 、我的显卡显存总是占不满,浪费一些,怎么破?
答:配置--expert-cache ,不要用 auto 档位。手动指定
让更多的专家进驻显存。注意,手动指定的是下限,所以要反复测试量力而行。
3 、我想使用上文的 conversation-cache ,但是我 RAM 都快满了,怎么办?
答:启用低内存模式:--resident-experts
小科普,正常默认情况下,strata 加载的专家是内存+SSD 加载全量,vRAM 加载高命中概率专家。相当于 RAM 和 vRAM 之间,是有一定的重复加载的。
官方这样指定默认值是有道理的,一旦 VRAM 的专家没能命中,直接可以读取 RAM 的进入 vRAM 。 代价就是这会导致 RAM 的极大浪费。
通过配置低内存模式,能够让 vRAM+RAM 分别加载不同专家,分工合作。这样能节省巨量 RAM 。代价是一旦 VRAM 中的专家没能命中,除了从 RAM 读取以外,还要从 vRAM 剔除一个回写到 RAM 。但相较于直接节省 40GB 的 RAM 空间而言,这点回写简直可以忽略不计。而且你显卡的显存越大,遇到回写的概率越低。 笔者的是 48GB 的 rtx pro 5000 ,专家命中率一直保持在 99%。
4 、我想多个聊天会话一起聊(并发),怎么办? 答,配置 parallel: X ( X 是并发会话数,最大 8 )
会占用显存,我个人实测,IQ3_XXS 量化下,会话长度 262k ,每个并发占用 5.2GB 显存。
以上,欢迎列位交流,指正。最后列出我个人的全套参数,供各位参考。
"args": [
  "--pack", "C:\\work\\Strata-data\\packs\\iq3_xxs",
  "--native", "C:\\work\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00001-of-00002.gguf",
  "--ple-gguf", "C:\\work\\Strata-data\\models\\IQ3_XXS\\Qwen3.8-Flash-Next-GSQ-RCO-IQ3_XXS-00002-of-00002.gguf",
  "--expert-profile", "C:\\work\\Strata\\data\\expert-profile.bin",
  "--resident-experts",
  "--expert-cache", "19000",
  "--prefill", "auto",
  "--spec", "4",
  "--mtp", "C:\\work\\Strata-data\\mtp\\rt",
  "--max-context", "262144",
  "--kv", "k8v4",
  "--vision",
  "--vram-reserve-mib", "3400",
  "--pcie-frac", "0.00",
  "--spec-min-p", "0.70",
  "--conversation-cache-mib", "27648",
  "--conversation-cache-slots", "9",
  "--conversation-cache-min-free-mib", "8192",
  "--prompt-cache-every", "8192"
 ],


 Select Language