
架构说明
首先说明一下我的使用环境以及模型配置:Claude Code + Trellis
Opus
负责 Plan + Check ( Review )
- 唯一选择:GPT-Sol(xhigh)
Sonnet
负责主会话 + Implement
- 首选:GLM(max)
- 备选:GPT-Terra(xhigh)
Haiku
负责 Research / Explore
- 首选:GLM-Flash(high)
- 备选:GPT-Luna(xhigh)
为什么 Sonnet 和 Haiku 优先选 GLM
GLM 又快又好,并且我有之前 180 一年的 Lite ,非高峰期还是比较耐用的。 GPT 应当只负责顶尖智能。
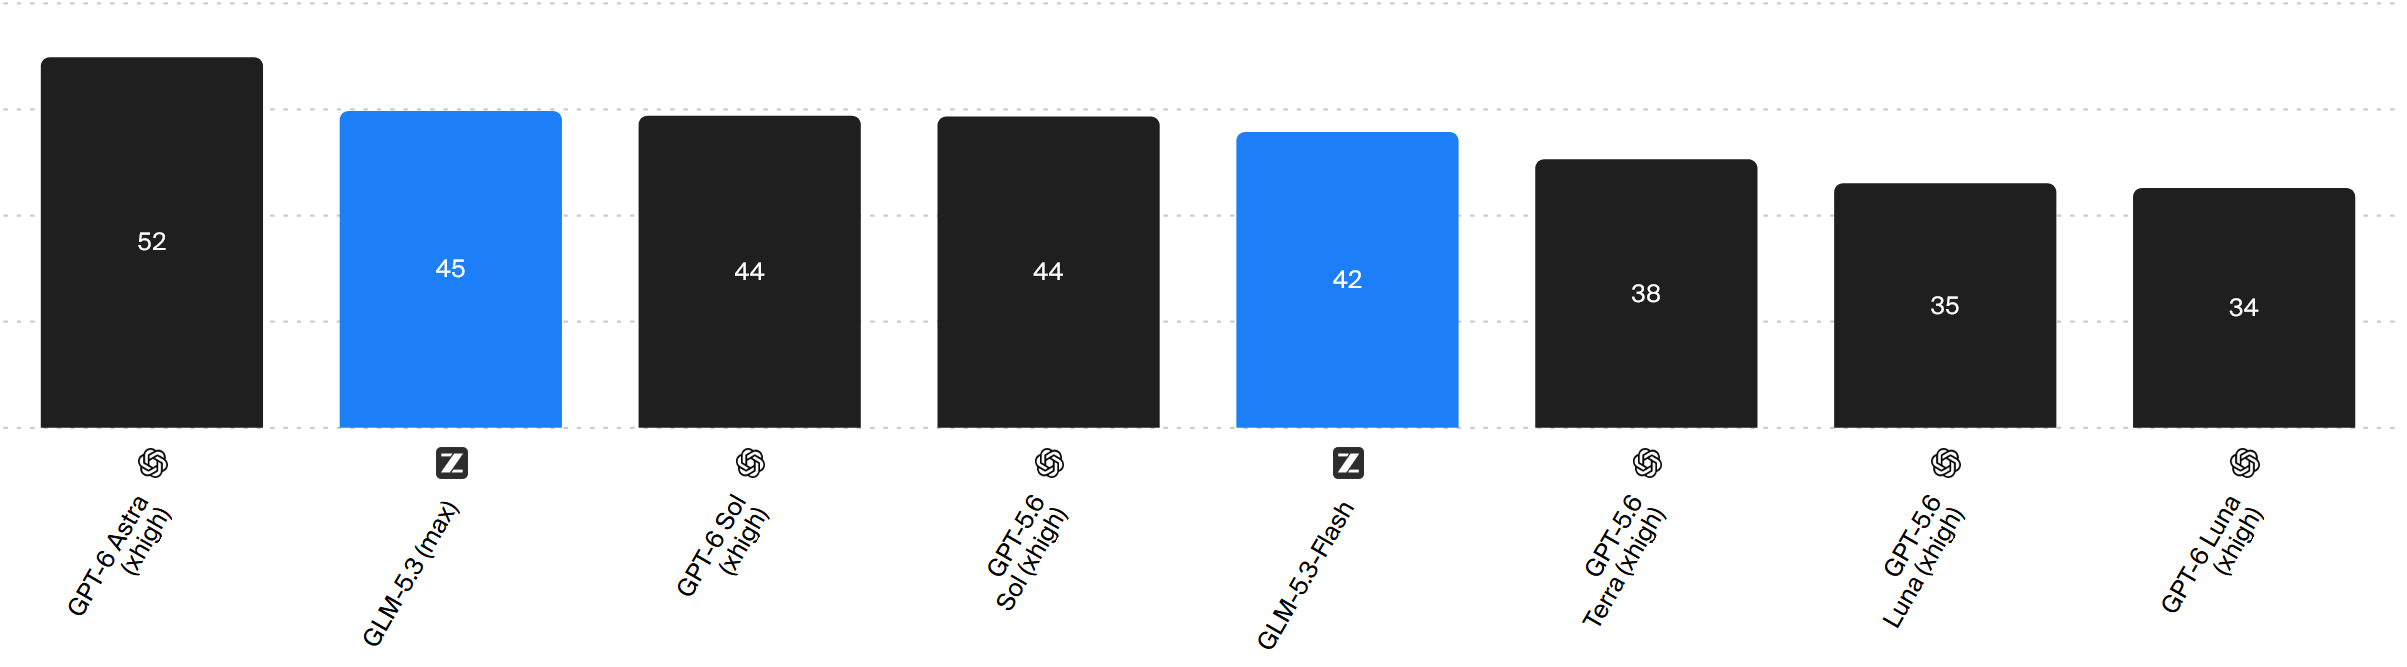
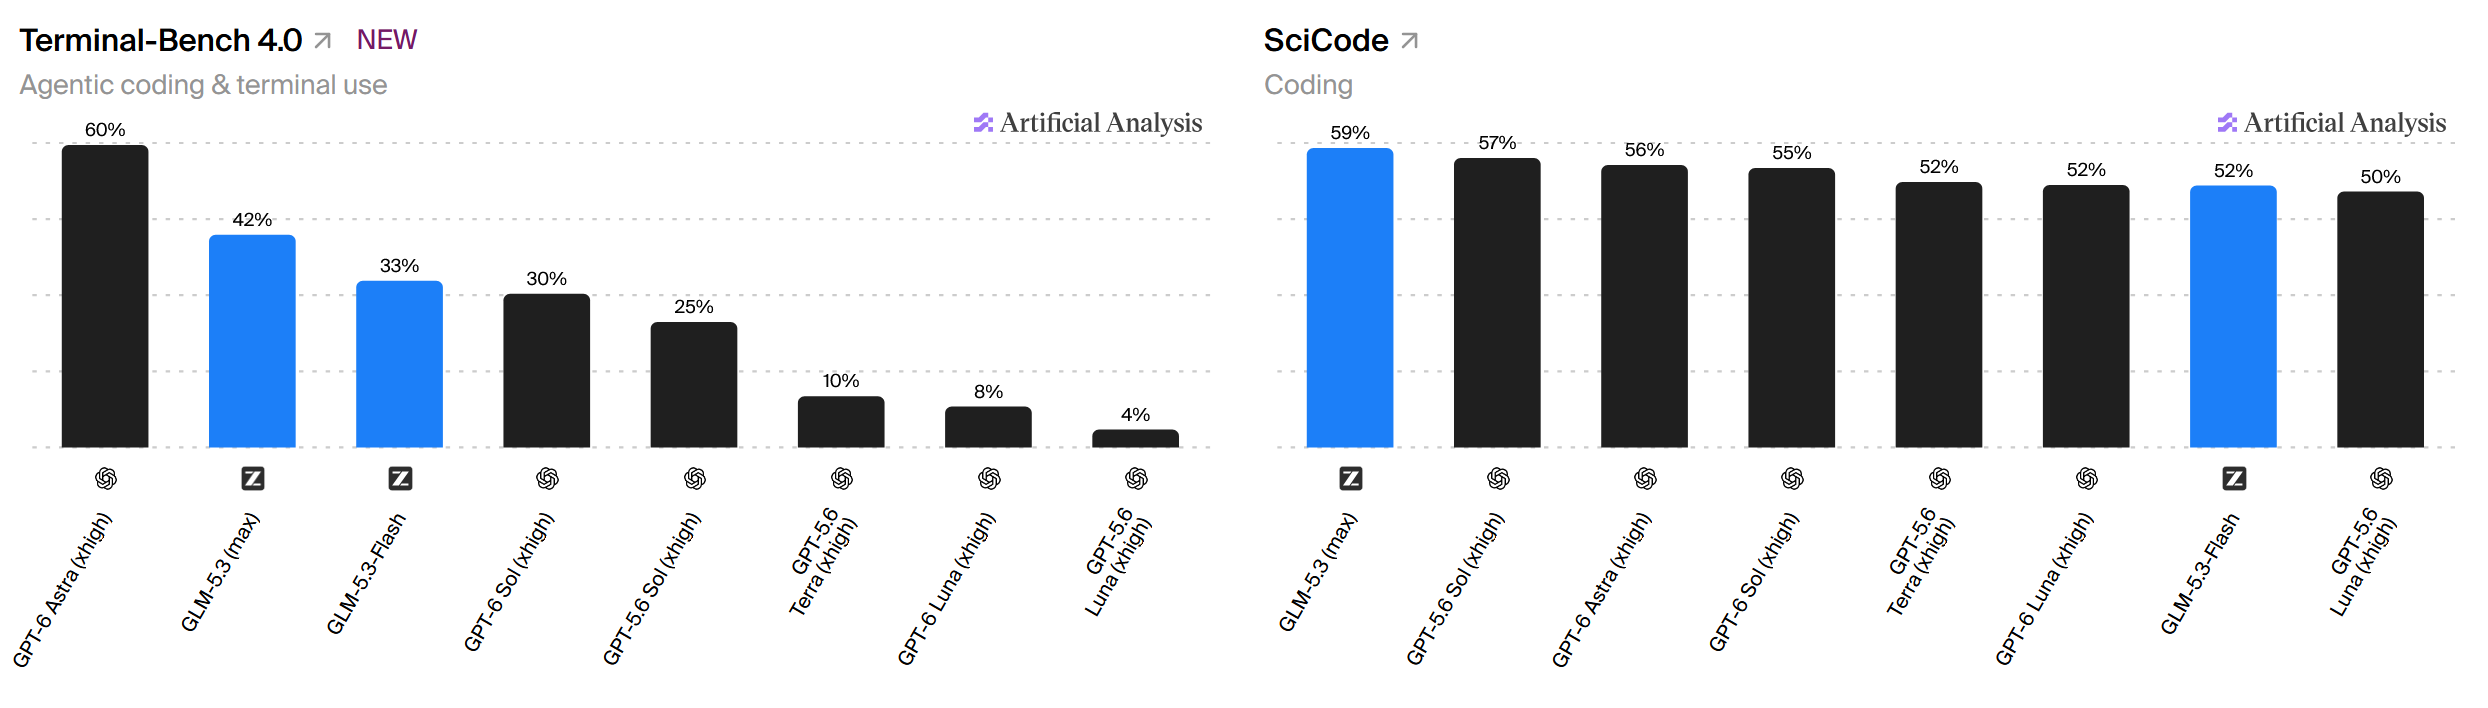
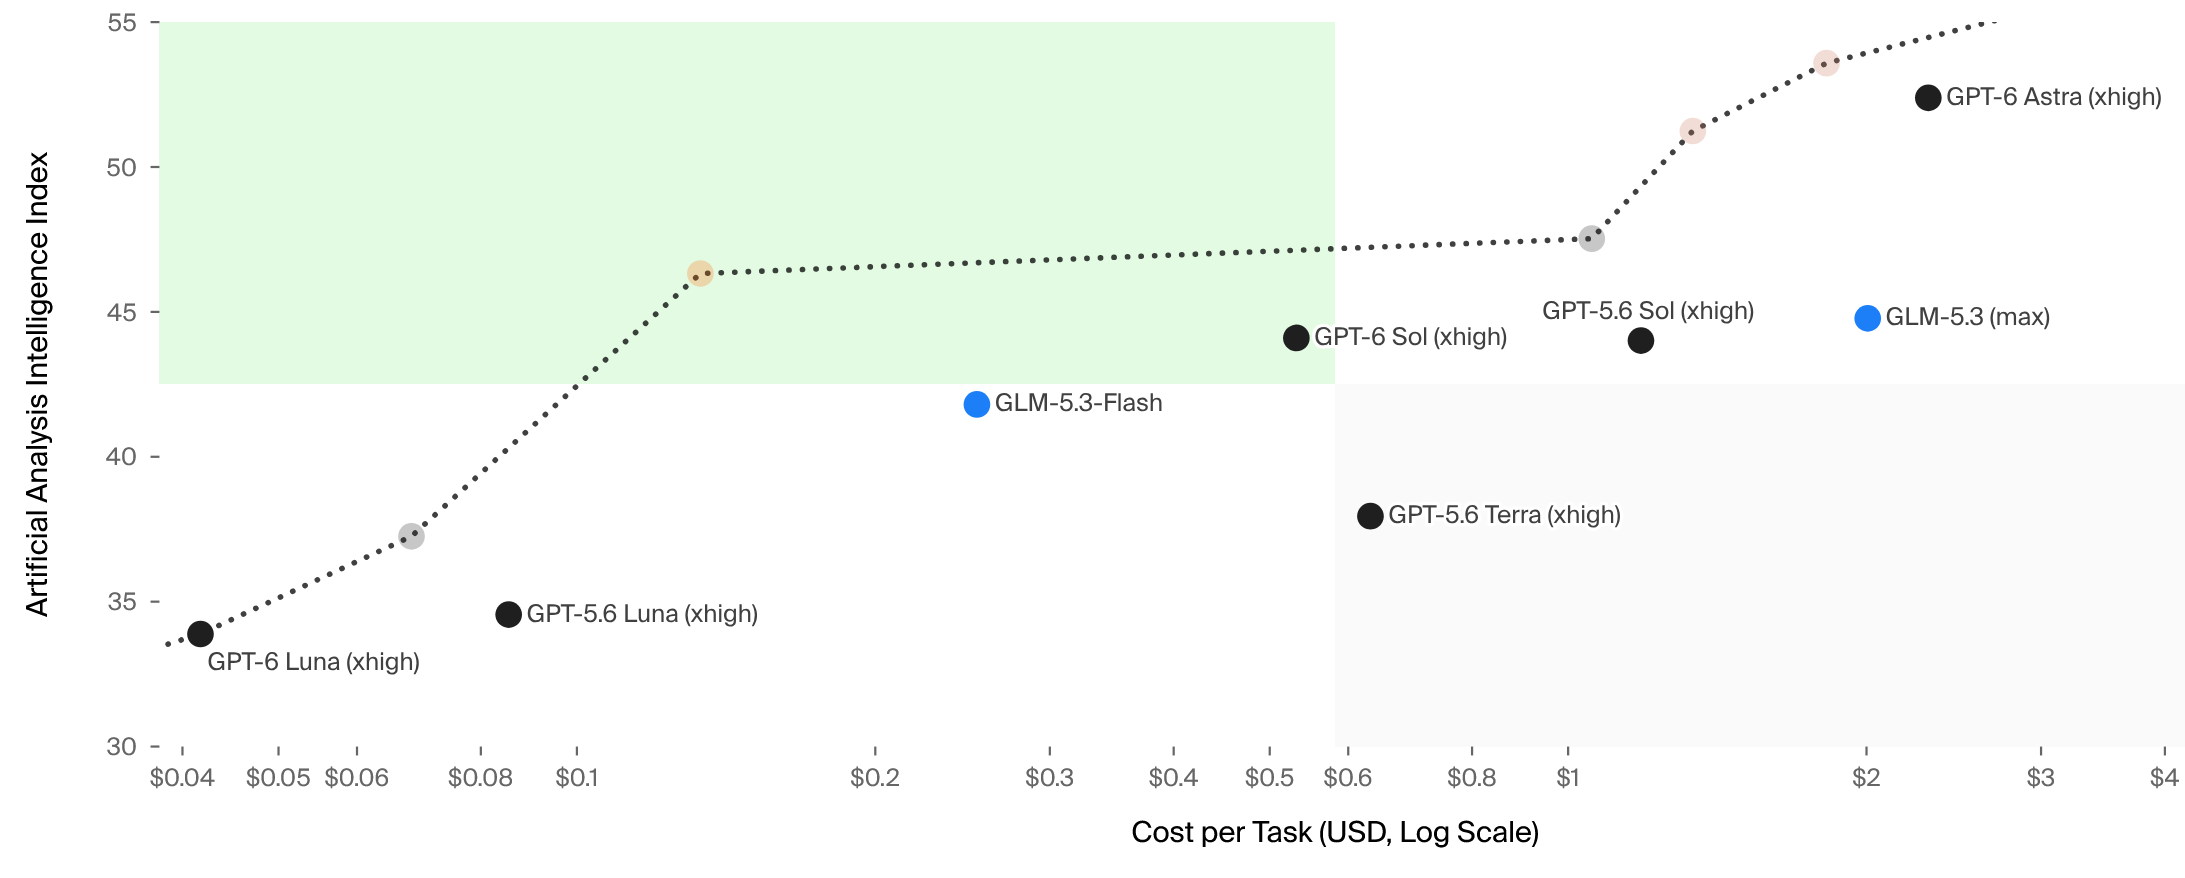
具体模型映射
GPT-Sol
- Before: GPT-5.6-Sol(xhigh)
- After: GPT-6-Sol(xhigh)
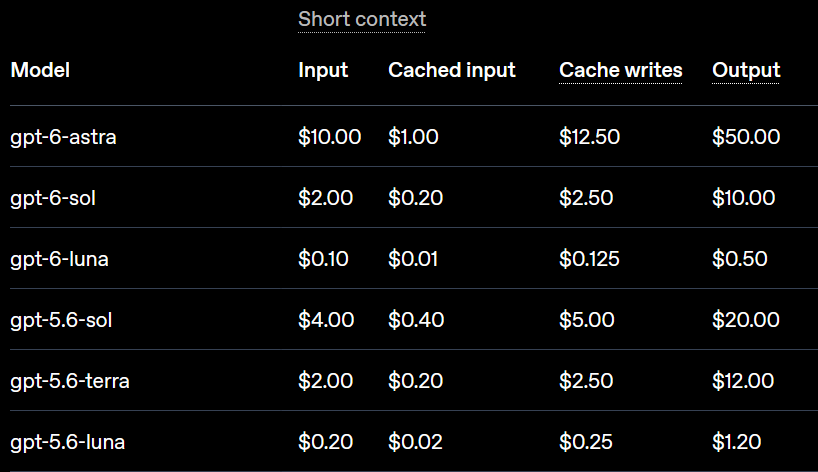
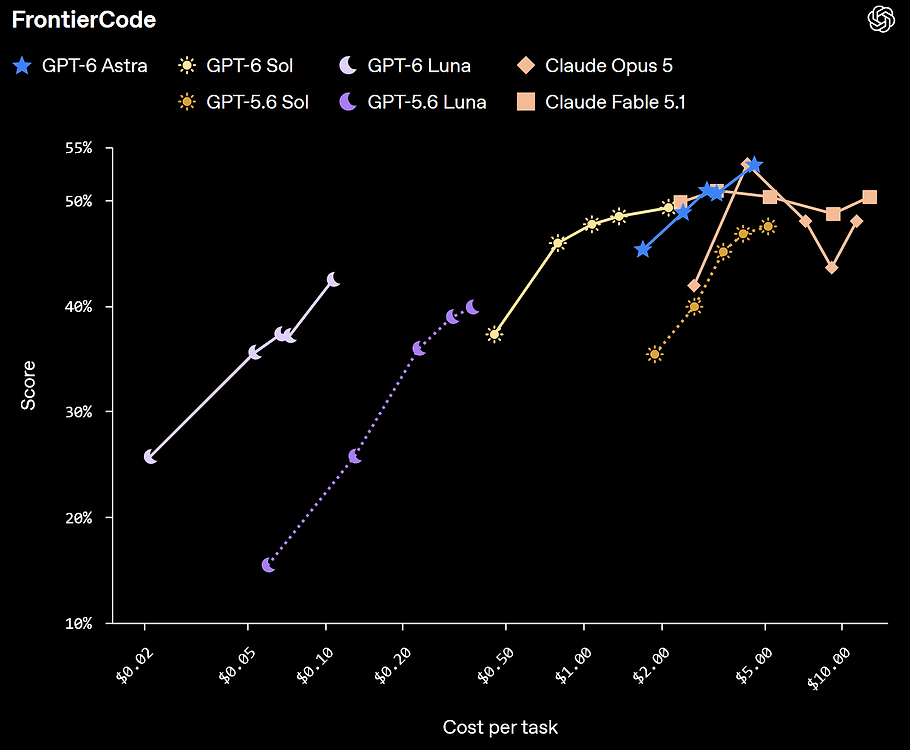
没啥好说的,半价 + 智能水平不降,直接替换。 为什么不使用 Astra ?:plus 套餐根本用不起
GPT-Terra
- Before: GPT-5.6-Terra(xhigh)
- After: GPT-6-Sol(high)
按价格来看,现在的 6-Sol 其实就是之前的 5.6-Terra ,我估计模型容量上是一样,只不过经过后训练对齐,效果变好。
GPT-Luna
- Before: GPT-5.6-Luna(xhigh)
- After: GPT-5.6-Luna(xhigh)
6-Luna 智能水平在 xhigh 等级是明显的下降,max 我觉得 research 工作没必要。 而且 Luna 本来几乎等于不要钱,即使更便宜,我觉得也感知不强。


 Select Language